
 野生码农

如何科学构建 AI 数字人团队:工作流、Agent 描述、技能体系、MCP 与军师配置治理
内部决策研报 · 数字团队治理 | 2026-09-08 本地台账/故障复盘 × 20 份外部一手文献交叉验证 关键词:数字人团队 · 多 agent 判据 · 上下文工程 · Agent Skills · MCP 工具治理 · eval 驱动 · 配置治理 · 记忆机制
研究摘要
对象:本项目 CrewAI 数字员工引擎(7 个团队 yaml)+ 军师编排体系;方法:本地台账、故障复盘与外部一手文献逐条对号。核心结论前置:
- 博客首战翻车的根因不是闸口失效,而是闸口没覆盖"复用率"维度:五份文档、四次品控拦截全部通过,却平行重造了框架 90% 的已有能力,17 个 run 实耗 1044 万 token 零可用交付。
- 多 agent 不是默认解:Anthropic 实测多 agent ≈ 单轮 chat 的 15 倍 token,且明确不适合大多数编码任务;Google 260 配置实验显示顺序规划任务多 agent 性能 -70%。本项目 ipdev 编码大卡烧穿、小卡 100% 交付,正是同一规律的本地实证。
- 配置臃肿有可量化的代价,不是审美问题:755 行指令文件实测 80-95% 规则冗余;18 个主流模型性能全部随上下文变长衰减;本地 yinliu 产线瘦身后 token -82%、耗时 -64%。
- 工具膨胀同理,且"藏起来"反而更准:58 个工具开机即吃约 55K tokens;Tool Search 按需加载后 Opus 4 选择准确率 49%→74%。crewai-docs MCP 移除又恢复事件的教训是:退役判据用错,不是工具用错。
- "越用越聪明"有真实机制也有噱头:Voyager 技能库消融 -93%、Reflexion 靠编译器/测试等外部反馈成立;DeepMind 实证无外部反馈的自我纠正反而更差。本项目的台账即记忆系统,最大缺口=故障台账尚未转化为 eval 回归用例。
一、失败解剖:首战翻车与"降智"真相
1.1 时间线:从实战检测令到停单令
09-06 白天 ipdev 产线大改(通用化 + rules 连增五节,验收状态⏳"首个真实开发单验证全链路");09-06 18:29 本人下达"实战检测"令,任务=把 BuildAdmin(ThinkPHP8+Vue)个人博客改造为 GEO 优化的服务端直出站,走 ipdev 产线;09-07 03:40 Kimi 周额度烧穿;09-08 ZCode 接管;09-08 本人亲测后台"分类"功能报错,宣布失败并下停单令。(来源:notes/AI工作/blog/2026-09-08 复盘,已核实)
1.2 失败表现:六个面,没有一个是"闸口坏了"
- 重复造车:旧站已有 Articles/Category/Attachment/Config 四套能力(git ls-tree 实证),产线却平行新建双文章后台、双表(ba_article vs ba_articles 一字之差)、双媒体库。选型文档明写"FR-18/19/20 近半功能开箱即用"——盘点做了,架构设计没有消费盘点结论。
- 越界改造:M3 卡改造共用文件,把旧后台分类页改崩(卡面明文授权,归因军师定卡缺陷)。
- 成本结构畸形:17 个 run 实耗 1044 万 token(usage 落盘真实值 10,442,852,619 次请求),prompt:completion ≈ 26.8:1(1006.7 万 vs 37.5 万)——读多写少,钱花在摸底上。
- 环境单低效:captcha 死亡 13 分钟 + M11a 二跑 48 分钟无预览且抢 IPMS 8000 端口;派单事实基线写错("本机无库",实际 MySQL 8.0 在跑)。
- 验收深度不足:模板注释
{*非 think-template 语法,整段漏渲染,溜过 coder 自检 + 军师复验双关。 - 军师虚报一次:"模板已加、台账已登记"实际未落盘。
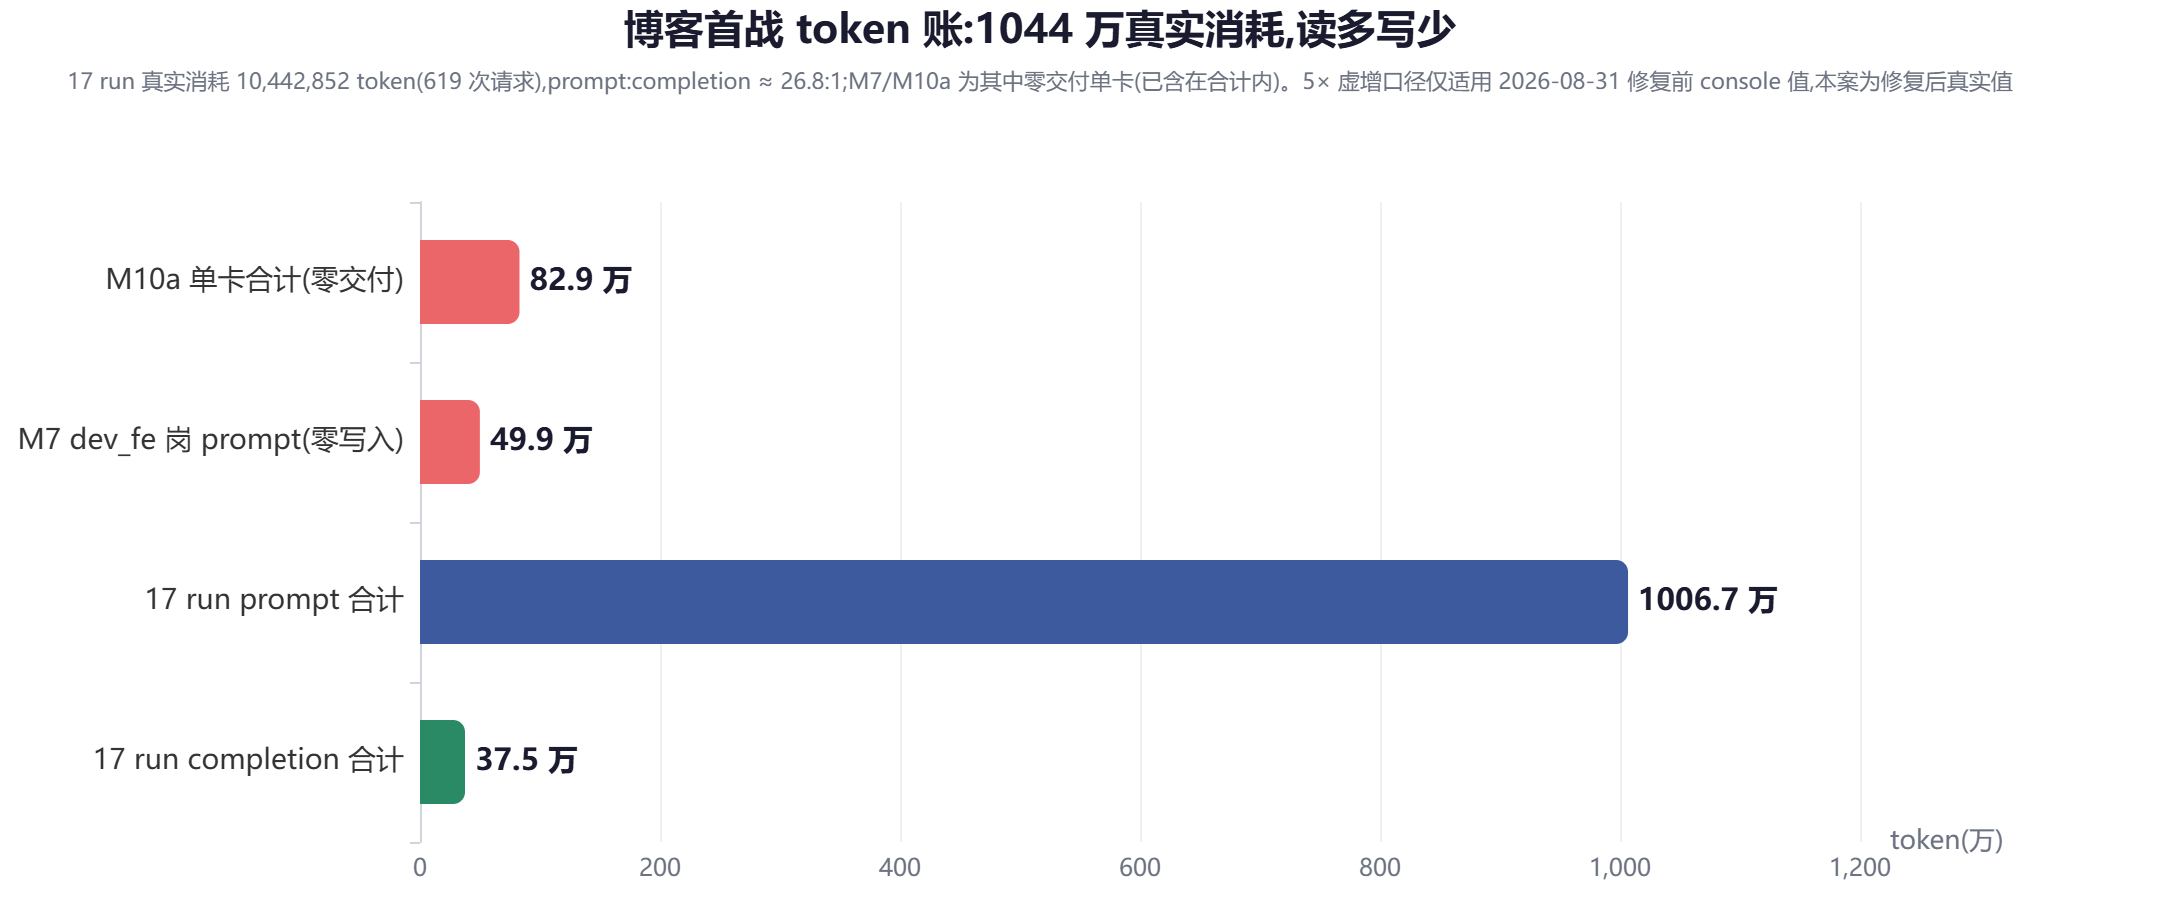
17 个 run 实耗 1044 万 token(真实落盘值 10,442,852,619 次请求),prompt:completion ≈ 26.8:1;M7/M10a 为其中零交付单卡(红色,已含在合计内,单列标示无效消耗)。来源:本地 usage 落盘 + 故障台账
⚠️ 此处手动上传图片:assets/charts/chart-03.png
1.3 六级归因与核心洞察
复盘稿给出六级归因链:①架构未消费选型盘点(总根因)②平行系统断裂 ③越界改造共用资产 ④任务卡缺"资产盘点"节和"本机环境侦察"行 ⑤执行岗烧穿与成本结构 ⑥军师侧失分(最优解审查形同虚设、验收停在语法装配级、虚报)。
核心结论:"不是某一环执行失败,而是五份文档 + 四次品控拦截,缺'复用率'一个检查维度,全链白干——闸口没坏,坏在闸口没覆盖的维度。"品控数量 ≠ 品控覆盖率;每加一道软判,都要先问它覆盖哪个失效模式。
1.4 纠正一个过时前提:ipdev 不是"IPMS 专属"了
"ipdev 只是 IPMS 专属产线"对 2026-08-23 初版(commit e110280)成立:fe/be tools 硬编码 file_write@D:/code/thinking/ipms/frontend,ui 角色写死"中后台管理系统",pm 写死"内部工具需求专家"。但 2026-09-07 commit a08305c 已完成通用化:tools 改 file_write@{project} 参数化,fe 角色改"现代框架通吃",rules.md 明写"目标项目章程优先",引擎加了 --project 参数。(来源:D:/code/CrewAI git 历史,已核实)
真实问题剩三条:①通用性未经第二个项目验证——通用化后 16 个 usage 落盘 project 全是 D:/code/php/BuildadminAi;②full 链缺编码任务——只有 5 个文档任务,rules.md §六还引用了 tasks.yaml 中不存在的"编码链 tasks"(引用悬空);③src/tools.py 与 README 残留 3 处注释级 IPMS 示例。再按"ipdev 专属化"开药方,就是治一个已经治好的病。
1.5 "降智"的另一面:配置臃肿的硬证据
登记册 2026-09-06 实测:全机配置文件 124 个(P0 16 / P1 60 / P2 48)+ 附属 52 项 = 170 项。臃肿前排:
| 文件 | 实测行数 | 判断 |
|---|---|---|
| zdq/AGENTS.md | 434 行 | 超章程预算(<200 行)1.2 倍,全机最臃肿 |
| ai-dev-blog/SKILL.md | 246 行 | 超技能预算(<150 行)64%,须拆分 |
| output/team 旧人格文档 | 8 份共 1561 行 | 与现役 yaml 双轨并存,漂移源 |
| yinliu tasks.yaml | 382 行 | 距 400 行预警线 18 行 |
臃肿不是感觉,是实测行数;且 zdq 双章程(AGENTS.md + CLAUDE.md)漂移已在发生。(来源:docs/config-registry.md,已核实)
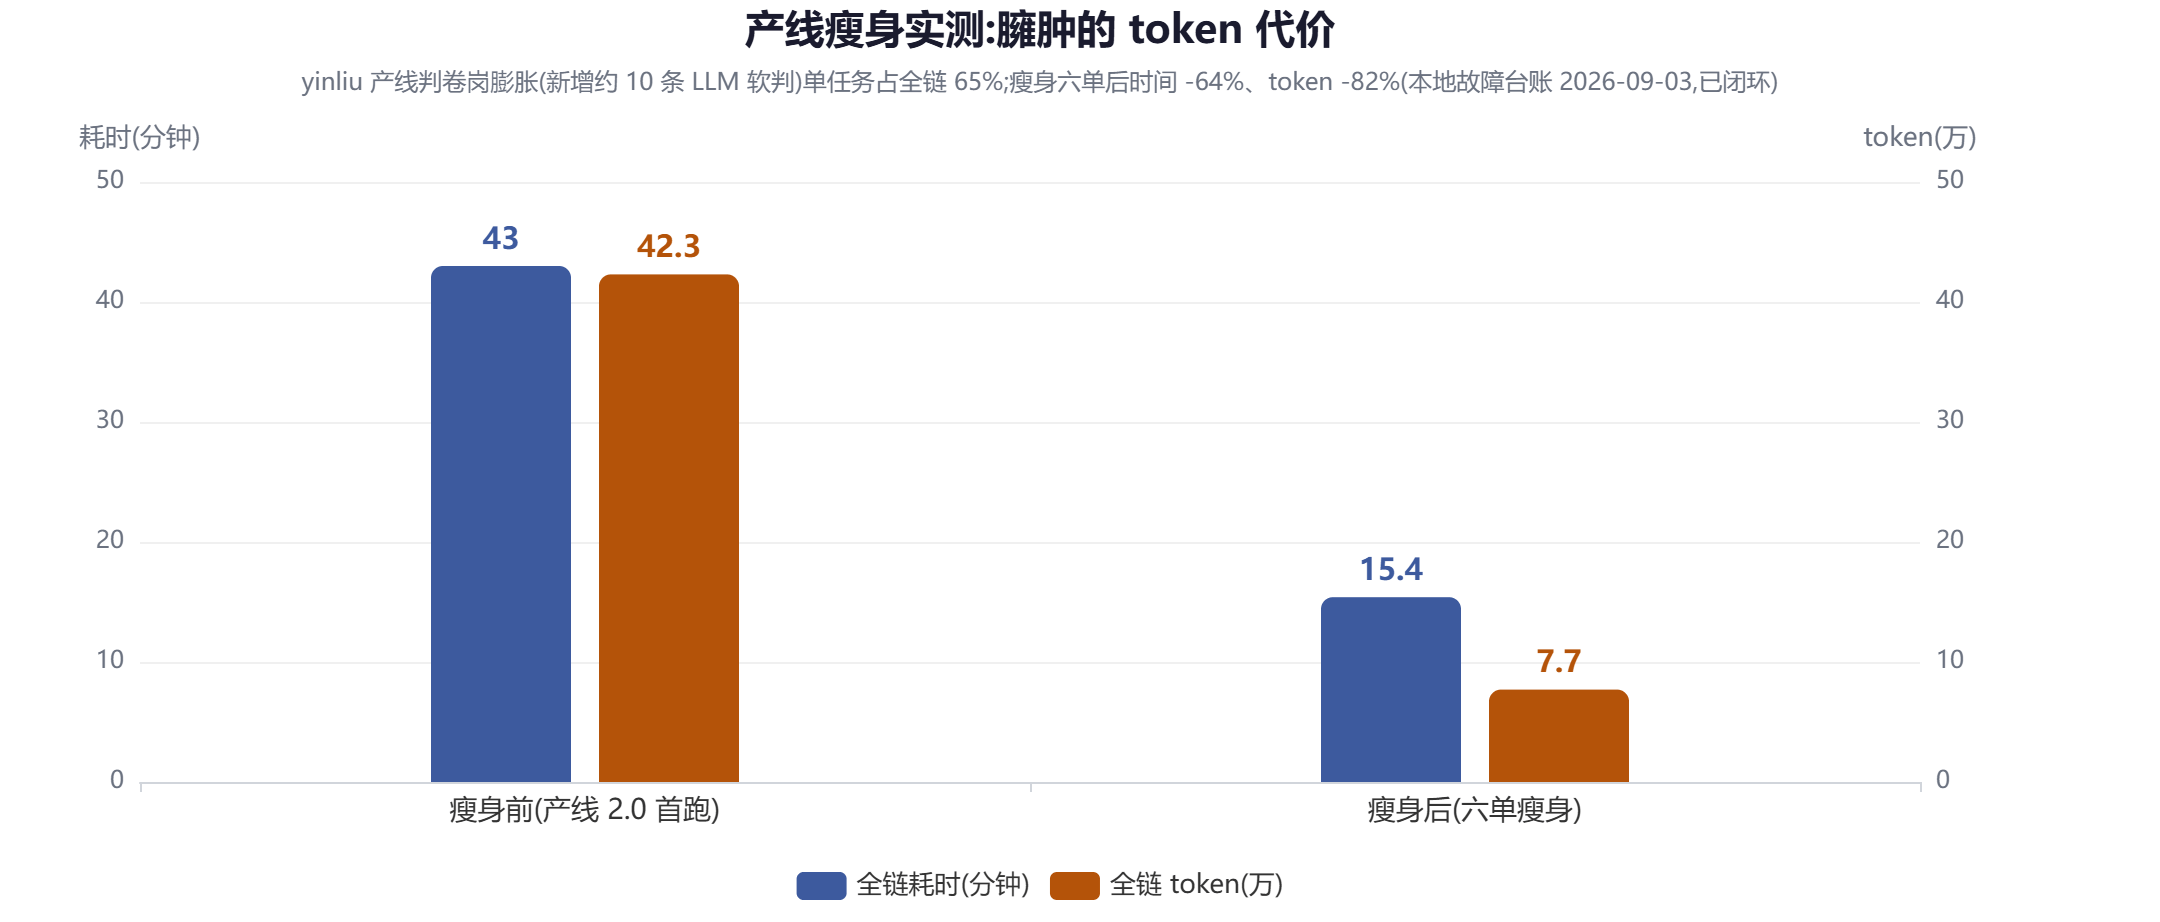
yinliu 产线判卷岗膨胀(新增约 10 条 LLM 软判)单任务占全链 65%;瘦身六单后 43min/42.3万token → 15.4min/7.7万token,时间 -64%、token -82%。来源:本地故障台账 2026-09-03,已闭环
⚠️ 此处手动上传图片:assets/charts/chart-02.png
核心结论(对本项目意味着什么):"军师降智"不是模型变笨,是三个可修复的工程问题叠加——闸口覆盖维度缺失(复用率)、任务卡事实基线缺失(摸底烧 token)、配置文件超预算臃肿。首日机制修正已落地(架构岗加"⓪复用映射表"硬闸、任务卡加"资产盘点"节),但修正效果 7-14 天内必须凭产线数据回填台账,否则又是一条未验证规则。
二、工作流科学:单 agent / 工作流 / 多 agent 的判据
2.1 三家一手证据
Anthropic《Building effective agents》:找尽可能简单的方案,只在需要时增加复杂度。工作流 = 预定义代码路径,agent = LLM 动态指挥;复杂度谱系:prompt chaining → routing → parallelization → orchestrator-workers → evaluator-optimizer → 自主 agent。(2024-12-19,已核实)
Cognition《Don't Build Multi-Agents》:原则一,共享完整 agent trace 而非单条消息;原则二,动作携带隐含决策,冲突决策导致坏结果。默认排除违反两原则的架构,最简合规 = 单线程线性 agent。(2025-06-12,已核实;2026-04 立场软化:写操作单线程 + 额外 agent 只贡献智能不贡献动作——评审类——可行,二手)
Anthropic 多 agent 研究系统复盘:agent 单次任务 ≈ chat 的 4× token,多 agent ≈ 15×;有效条件 = 高价值 + 重度可并行 + 信息超单窗口 + 大量工具;明确不适合大多数编码任务(可并行部分比研究少,不擅长实时协调委派)。多 agent 比单 agent 内部 eval 高 90.2%,但 BrowseComp 上 token 用量单独解释 80% 性能方差——多花 token 本身就是主要机制。
Google Research(arXiv:2512.08296):260 配置 × 5 架构 × 3 模型族,相对单 agent,可分解金融推理 +80.8%,顺序规划任务 -70.0%;单 agent 基线超过约 45% 后,协调收益递减甚至为负。(v3 2026-04-08,已核实)
2.2 架构选型判据矩阵
| 架构形态 | 适用判据(全满足才升级) | 反信号(出现即降级) |
|---|---|---|
| 单 agent + 工作流 | 步骤可预定义;顺序依赖强;单上下文装得下 | ——(默认起点,Anthropic"能简不繁") |
| 并行化只读多 agent | 重度可并行;信息超单窗口;子任务互不写共享资产 | 并行化写(违反 Cognition 原则二,决策冲突) |
| 编排-工人多 agent | 高价值任务;token 预算 ≥15× 仍划算;共享完整 trace | 顺序规划类任务(-70%);单 agent 基线已 >45% |
| 编码任务 | 单线程写盘 + 评审 agent 只贡献智能(2026-04 软化口径,二手) | 多 agent 并行写代码:Anthropic 明确"不适合大多数编码任务" |
一句话判据:并行化读,不要并行化写;多 agent 的收益要先证明值 15 倍 token。
**核心结论(对本项目意味着什么):**ipdev 博客首战的容量边界实测——小卡(≤100 行卡面)交付率 100%,大卡(M2 前端/M10ab)失败率高——正是"编码任务多 agent 化"的本地实证:M10a dev_be 单岗烧 52.4 万 prompt token 零写入。处置方向正确且已有硬边界:单卡交付文件 ≤6 个或卡面 ≤120 行,超出先拆卡;大卡编码降级为 coder 子代理单线程写盘,crew 只做设计与评审(贡献智能不贡献动作)。这条边界与判据矩阵完全同构,应固化为产线选型铁律。
三、Agent 描述科学:提示词的 Goldilocks 高度
3.1 最小信息集:不多不少,刚好够
Anthropic 上下文工程给出系统提示词的 Goldilocks 高度:不硬编码 if-else 细节,不写空泛口号,目标是能完整描述期望行为的最小信息集;操作路径=先用最小提示词测最强模型,按失败模式逐条补指令。(2025-09-29,已核实)
为什么"多写"有害,证据是硬的:Chroma《Context Rot》实测 18 个主流模型性能全部随输入变长而下降且非均匀,干扰项越多衰减越快;"只给相关 300 token"对"全量 113k",所有模型 focused 条件显著更优。社区 eval 实测:755 行指令文件 80-95% 规则冗余,有无该文件 26 条断言 25 条表现相同;ICLR 2025《Curse of Instructions》指令 1→20 条 follow rate 非线性劣化;arXiv 2606.20512 更反直觉——LLM 自动生成的章程文件反而降低任务解决率。另有二手转述:Anthropic 删 Claude Code 超 80% system prompt 后编码评测无可测量损失(二手,原帖未抓到)。
3.2 上下文四病:每个失效模式都对应一种写法错误
| 病症 | 机制 | 配置侧对策 |
|---|---|---|
| poisoning | 幻觉进入上下文后被当事实引用 | 关键事实只信落盘台账/工具回读,不信 agent 自述 |
| distraction | >100k 后重复历史动作 | 长任务用压缩/结构化笔记,不裸堆历史 |
| confusion | 每个模型在多于一个工具时表现都变差;Llama 3.1 8b 给 46 工具失败、19 个成功 | 岗位最小工具集;职责重叠的工具必合并 |
| clash | 信息分片给齐平均掉分 39%,o3 从 98.1→64.1;早期错误留在上下文"走错路回不来" | 事实基线一次给齐进卡面,禁分轮补料 |
来源:Breunig 上下文四病综述,2025-06-22(已核实)。四病全部指向同一处方:上下文是稀缺资源,按"最小够用量"配给。
长程任务三技术:压缩(先召回后精度)、结构化笔记(NOTES.md 式)、子 agent 隔离(子 agent 耗数万 token 探索,回传 1-2k 蒸馏摘要)。这与本项目"卡面要求先读 N 份文档的,必须把关键事实预摘要进卡面"的规则沉淀同构——M7 烧 49.9 万 prompt token 零写入,就是没做蒸馏。
3.3 "负面指令优先"与官方口径的张力:裁决建议
本项目章程纪律写"负面指令优先于正面倡议";Anthropic 官方提示词文档写"告诉模型要做什么,而不是不要做什么"。两条都有依据,直接冲突。裁决建议(按失效模式分工):
- 硬边界 → 用负面指令:防越权、防越界、防虚报、防整链重烧:写成"禁止/不许"+量化阈值,能机器判定的同时配 hooks/脚本硬闸。本项目实例:"禁整链重烧""单卡 ≤6 文件或 ≤120 行"——都是事故驱动添加。
- 期望行为 → 用正面指令:描述输出形态、工作步骤、质量标准:写成"要做什么",因为"不做 X"不给替代路径,模型仍会任选。官方同文还给出排版证据:长文档放顶部、查询放末尾,质量提升最多 30%。
一句话:负面指令管"不许碰的红线",正面指令管"该走的路";同一条规则里混用两种语气 = 指令冲突 = 模型任选一个执行(写法规范元规则)。
**核心结论(对本项目意味着什么):**章程/技能的行数预算(章程 <200 行、技能 <150 行)方向正确且有外部证据背书;zdq 434 行、ai-dev-blog 246 行是已知超标项,拆分不是整洁癖,是恢复指令 follow rate。新增规则继续走"事故驱动 + 单次 ≤3 条"小剂量,拒绝预写——755 行文件 80-95% 冗余的实测就是预写的下场。
四、技能体系:Agent Skills 三级渐进披露
4.1 三级加载机制:上下文按用量付费
Anthropic Agent Skills 的核心是三级渐进披露:一级=启动时只预载 name + description;二级=判定相关才读 SKILL.md 正文;三级=references/ 附属文件按需读。"可打包上下文量实际无上限"——上限被转移到了文件系统,上下文窗口只装当前任务需要的部分。技能哲学 = 新员工入职手册:用可组合的流程知识特化一个通用 agent,而不是为每个场景定制一个碎片 agent。(2025-10-16,已核实)
规范硬指标(agentskills.io/specification,访问 2026-09-08):SKILL.md ≤500 行,正文建议 <5000 tokens,description ≤1024 字符且必须写"做什么 + 何时用",引用链只许一层深,scripts/ 放可执行代码,allowed-tools 做技能级工具白名单。
4.2 对本项目的映射:方向已对齐,局部超标
| 官方机制 | 本项目现状 | 判断 |
|---|---|---|
| 三级渐进披露 | 技能手册不随会话注入,四类场景按需调用;references/ 子目录已建制 | 对齐 |
| SKILL.md ≤500 行 | 本地预算 <150 行,比官方更严;crewai 143 行逼近线,ai-dev-blog 246 行超标 64% | 局部超标 |
| 引用链一层深 | 未实测全机技能引用深度 | 待核查 |
| allowed-tools 白名单 | 岗位最小权限已写入军师职责;装配审计器硬断言"承诺能力但零工具=假技能" | 对齐 |
ai-dev-blog 246 行拆法:正文只留调用口径与硬规则,写作栈细节(humanizer/声口/标题评分)下沉 references/,与官方"正文 <5000 tokens"同向。
**核心结论(对本项目意味着什么):**渐进披露不是可选项,是上下文经济学的唯一解;本项目 150 行预算比官方 500 行更严,方向正确,接下来要做的不是加码规则,而是把超标技能(ai-dev-blog 为首)按"正文口径 + references 细节"拆开,并把"引用链一层深"纳入装配审计 WARN 项。另注:CrewAI 的 role-goal-backstory 三件套是框架约定,官方无性能增益实证——写角色描述应按"最小信息集"标准,别把 backstory 写成小说。
五、MCP 与工具:膨胀的代价与"藏起来更准"
5.1 膨胀的实测代价
Anthropic 工具工程文给出实测:5 个 MCP server、58 个工具,会话开始前就吃掉约 55K tokens;内部见过 134K 的案例。最常见失败模式 = 选错工具和填错参数。(2025-11-24,已核实)
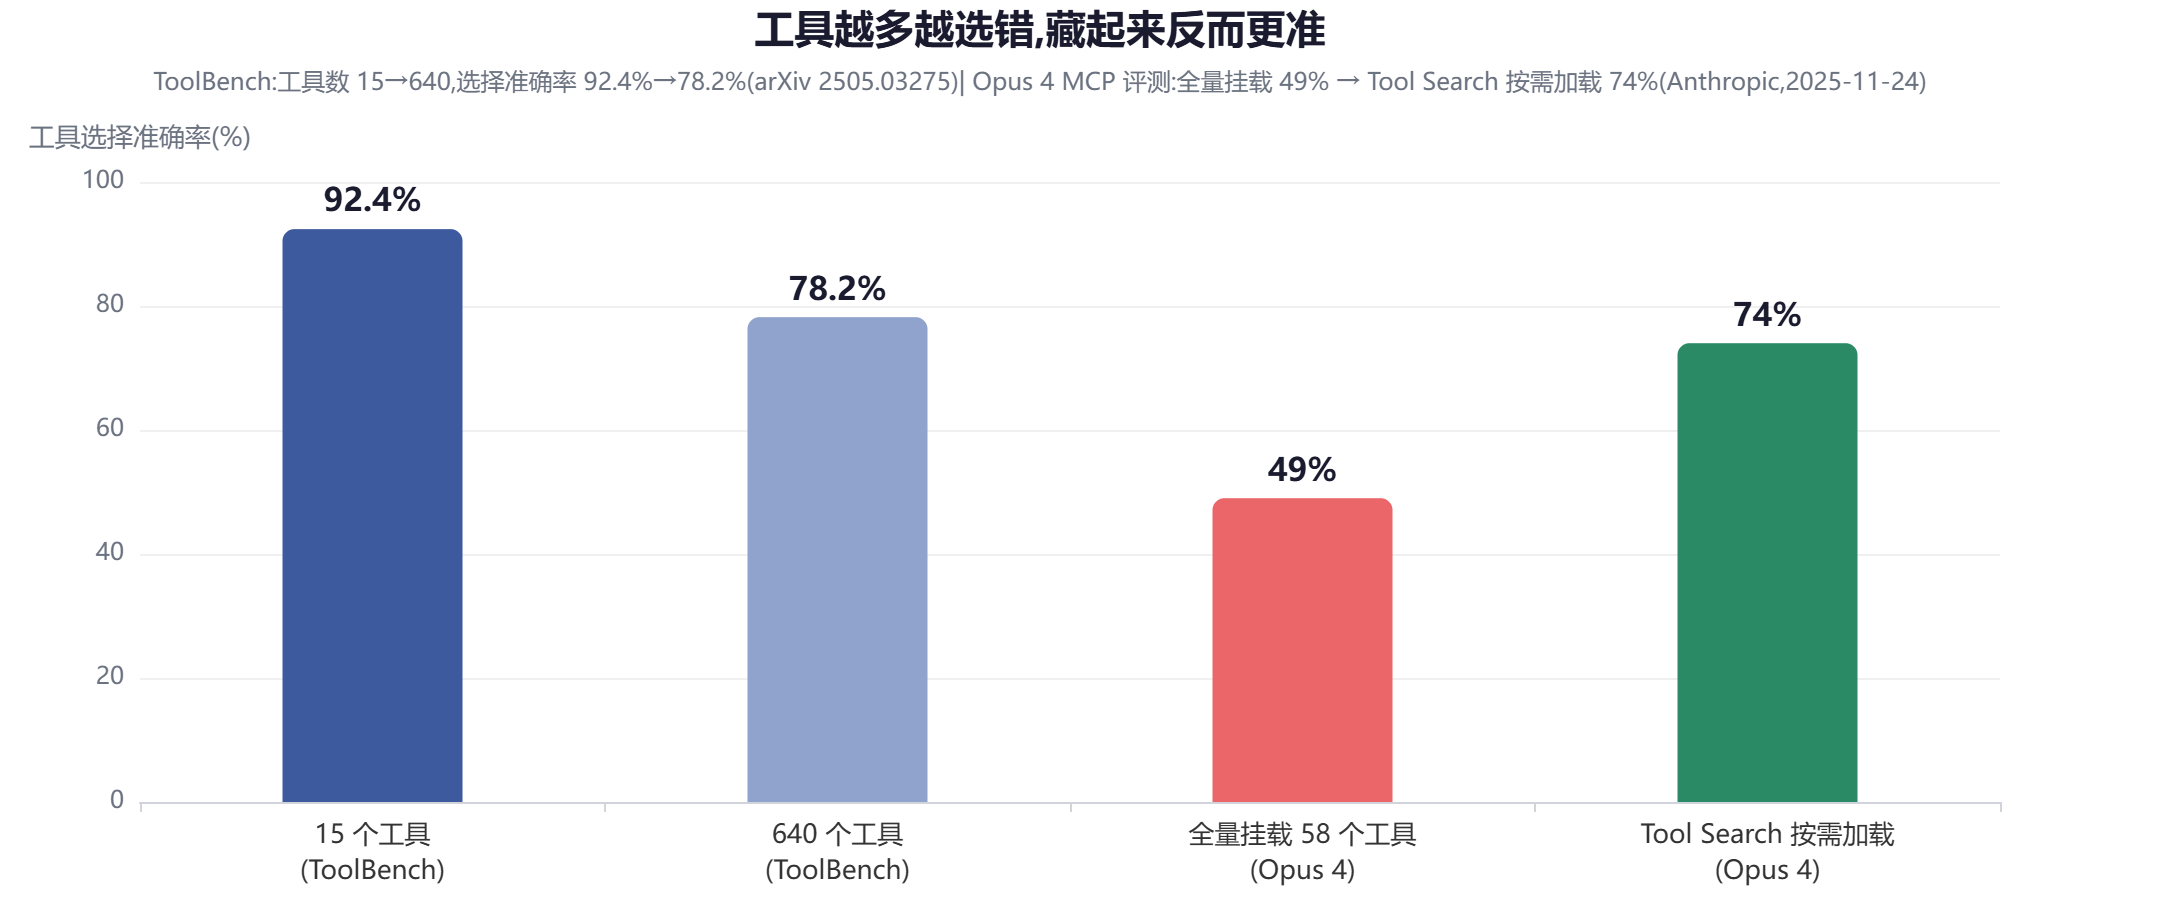
ToolBench:工具数 15→640,选择准确率 92.4%→78.2%(arXiv 2505.03275);Opus 4 MCP 评测:全量挂载 49% → Tool Search 按需加载 74%(Anthropic,2025-11-24)。核心结论:工具膨胀的解不是删,是按需加载
⚠️ 此处手动上传图片:assets/charts/chart-01.png
解法不是删工具,是按需加载:Tool Search(defer_loading)token -85%,MCP 评测准确率 Opus 4 从 49%→74%、Opus 4.5 79.5%→88.1%;官方建议启用阈值 = 工具定义 >10K tokens 或工具数 ≥10。极端路线是把工具呈现为代码 API:token 150,000→2,000(-98.7%),Cloudflare Code Mode 独立印证。
5.2 工具设计的四条工程纪律
- 按高价值工作流合并,不按端点铺开:一个"跑通流程"的工具胜过五个"各管一段"的工具。
- 命名空间显著影响选择正确率;返回自然语言标识降低幻觉。
- 工具描述值得重写:重写后任务完成时间 -40%;Tool Use Examples(1-5 个真实调用示例)使复杂参数准确率 72%→90%。
- 编排者判断标准:"如果人类工程师都说不清某场景该用哪个工具,就别指望 AI agent 能选对"——维护最小可行工具集。(2025-09-11 等,已核实)
5.3 本地案例:crewai-docs MCP 移除又恢复——判据错,不是工具错
09-06 台账记录 crewai-docs MCP 被移除,09-08 撤销恢复,本人裁定军师主责:"官方文档通道属产线基础设施,不适用白挂退役判据"。这次事件的正确抽象是:工具治理要分两类——
- 基础设施通道(常驻):官方文档、引擎自检、装配审计:产线运行离不开,判据=可用性与准确性,不适用"调用频率低就退役"。
- 按需工具(可退役):业务工具:判据=调用频率 + 选择准确率;职责重叠必合并(本地基线备忘:"15 个定义清晰的工具能跑,10 个职责重叠的就不行")。
退役判据用错对象,比不治理更伤——治掉了基础设施。
**核心结论(对本项目意味着什么):**①全机 MCP 按"基础设施/按需"二分登记,退役判据分开写;②按需工具超 10 个或定义超 10K tokens 的产线,评估引入按需加载/描述重写(-40% 耗时是白捡的);③每个业务工具补 1-5 个真实调用示例进 references/,复杂参数准确率 72%→90% 的收益不值得放弃。
六、军师能力模型:编排者该配什么
6.1 本地十项基线 × 外部证据对照
docs/agent-arch-baseline.md 定了军师能力考核十项,季度自评"无证据=不及格"。逐条对照本次调研的外部证据:
| 能力项 | 外部证据对号 | 首战表现 |
|---|---|---|
| 架构选型判断力 | Anthropic 谱系 + Cognition 两原则 + Google -70%(第二章) | 不及格:编码大卡多 agent 化烧穿 |
| 上下文工程 | Goldilocks 高度 + 四病 + 长程三技术(第三章) | 不及格:M7 摸底烧 49.9 万 token |
| eval 驱动品控 | eval 双轨制 + pass^k(见 6.2) | 不及格:闸口缺"复用率"维度 |
| 提示词角色设计 | 最小信息集 + 正负指令分工(第三章) | 部分:判卷 prompt 引用看不见的注入文件(08-28) |
| 工具接口设计 | 合并设计 + 描述重写 + 示例(第五章) | 部分:MCP 退役判据用错被裁定主责 |
| 成本与模型路由 | 15× 倍率 + token 解释 80% 方差(第二章) | 不及格:1044 万 token 零可用交付,周额度烧穿 |
| 多 agent 失败模式识别 | MAST 14 类分类法(本地基线引用;失败率区间未见一手出处,待溯源) | 部分:六级归因到位但为事后 |
| 安全边界 / 可观测性 / HITL | usage 逐 run 落盘 + --resume 半链续跑 + 装配审计四断言 | 达标:越界改造被卡面授权暴露;但出现一次虚报 |
十项中首战暴露 4 项不及格、3 项部分:与"军师侧失分"的复盘结论一致,能力清单不是文案,是考核表。
6.2 eval 双轨制与版本治理:品控的科学形态
Anthropic eval 方法论:能力 eval(低通过率爬坡,攻新能力)与回归 eval(近 100% 通过率,下滑即信号)双轨;能力集爬高后"毕业"转常驻回归集。pass^k 判据给稳定性一个数:单 trial 75% 通过率,连跑 3 次全过的概率 ≈ 42%——单次通过什么都证明不了。"eval 一旦存在,基线与回归测试就是免费副产品";有 eval 的团队换模型几天完成升级,没 eval 要数周。(2026-01-09,已核实)
工程化配套:promptfoo 类 CI 闸口(YAML 断言集 10-50 用例,prompt 回归失败阻断 PR);Prompt Registry 成熟类目(MLflow:版本不可变 + alias 秒级回滚 + eval 血缘,业界标准流 = 版本闸口 + 分阶段发布)。另有一个前沿警告:Opus 4.5 在 τ2-bench 发现政策漏洞给出更优解却被判失败——静态 eval 会被前沿能力反超,grader 需持续维护。
6.3 军师配置治理飞轮
- ① 实战:产线接真实任务,usage/异常逐 run 落盘(已有:logs/usage/)
- ② 归因对号:故障台账按 MAST 14 类 + 四病对号,归因到方案/工具/配置/能力(已有:docs/故障台账.md)
- ③ 失败转 eval 回归用例(当前缺口):每次翻车的失效模式写成 1 条断言进回归集;复用率检查、
{*语法扫描、事实基线校验都是现成候选 - ④ 小剂量变更:单次未验证规则 ≤3 条入库(已有:agent-config-sop 五工序)
- ⑤ 7-14 天数据回填:P0 变更凭产线数据回填台账验证结果 ✅/❌/⏳(已有:config-ledger;近 30 天 38 条变更 ✅16 ⏳15 混合 7 ❌0)
- ⑥ 再实战:回到①;改配置必跑回归集,不过闸不上线——飞轮闭环
**核心结论(对本项目意味着什么):**飞轮七环里五环已有建制(落盘/台账/小剂量/回填/审计),唯一断环是③失败转 eval 回归用例——这正好解释首战"闸口没坏但没覆盖":没有回归集,新维度只能靠下一次翻车来提醒。补上这一环,军师的"季度自评"才有可判卷的数据源。
七、越用越聪明:有效机制与噱头
7.1 有实证的三条机制
- 可复用技能库(Voyager,arXiv:2305.16291):自动课程表 + 代码技能库 + 环境反馈迭代提示;物品 3.3×、距离 2.3×、里程碑 15.3×。消融实验:课程表换随机 → 物品发现 -93%;去技能库 → 后期停滞。技能库不是加分项,是持续增长的前提。
- 接外部反馈的反思(Reflexion,arXiv:2303.11366):语言反思存情景记忆,HumanEval 91%;反思输入是编译器/测试等外部反馈,不是空想。
- agent 自我写技能(Anthropic 官方背书):把调通的任务代码持久化为可复用函数 + SKILL.md,"随时间积累,agent 自建高层能力工具箱"。记忆主流形态 = 文件式笔记(NOTES.md、compaction、memory tool),非神秘机制。
7.2 噱头判定:没有外部信号的"自我纠正"
DeepMind ICLR 2024(arXiv:2310.01798)实证:LLM 无外部反馈的自我纠正,性能不稳定甚至下降。判定规则:纯 prompt 层 self-critique 是噱头高发区;反思必须接环境/工具信号。对本项目的直接推论:判卷岗加 LLM 软判层数 ≠ 质量提升——yinliu 判卷膨胀新增约 10 条软判,单任务吃到全链 65% 的 token,正是"无外部信号的自我纠正"在产线上的形态;瘦身后 -82% token 反而更稳。
**核心结论(对本项目意味着什么):**本项目的"记忆系统"已经存在且形态正确——config-ledger(变更记忆)+ 故障台账(失败记忆)+ usage 落盘(运行记忆)就是 Voyager 技能库与 Reflexion 情景记忆的本地对应物。最大缺口:台账里的失败尚未转化为回归用例与可复用技能,记忆只存取不复用,等于 Voyager 去了技能库。优先动作:把故障台账逐条翻译为回归断言(闸口侧)与卡面模板补丁(技能侧),每条注明来源台账条目,验收线=下次同类翻车被闸口拦截而非被本人发现。
八、结语:七条可执行判断
- 架构选型先问值不值 15× token:编码任务默认单线程写盘 + 评审 agent 只贡献智能;ipdev 大卡拆卡边界(≤6 文件/≤120 行)已有实测背书,坚持执行。
- 配置即上下文,按最小信息集配给:行数预算继续执行;zdq 434 行、ai-dev-blog 246 行优先拆分;新规则保持事故驱动、单次 ≤3 条。
- ipdev 通用化已完成,别再治已好的病:待办=第二项目验证通用性、补 full 链编码任务或删 rules.md §六悬空引用、清 3 处 IPMS 注释残留。
- 工具分两类治理:基础设施通道(官方文档/审计)看可用性,按需工具看调用频率 + 选择准确率;退役判据再不许混用。
- 品控升级补断环:故障台账 → eval 回归用例,是当前投入产出比最高的一步;改配置必跑回归,不过闸不上线。
- 警惕无信号的自我纠正:加软判层数前先问"它接的是什么外部信号";接不上的就是 yinliu 判卷膨胀同款。
- 飞轮已经转起来五环:落盘、台账、小剂量、回填、审计都在;补上"失败转回归"这一环,"越用越聪明"才从口号变成机制。
参考文献
- Anthropic,Building effective agents,2024-12-19。https://www.anthropic.com/research/building-effective-agents
- Cognition,Don't Build Multi-Agents,2025-06-12。https://cognition.ai/blog/dont-build-multi-agents
- Anthropic,How we built our multi-agent research system,2025-06-13。https://www.anthropic.com/engineering/built-multi-agent-research-system
- Google Research,多 agent 架构大规模实验(arXiv:2512.08296,v3 2026-04-08)。https://arxiv.org/abs/2512.08296
- Anthropic,Effective context engineering for AI agents,2025-09-29。https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic,Prompt engineering:Be clear and direct。https://docs.anthropic.com/en/docs/build-with-claude/prompt-engineering/be-clear-and-direct
- Chroma,Context Rot,2025-07-14。https://research.trychroma.com/context-rot
- Drew Breunig,How contexts fail and how to fix them,2025-06-22。https://www.dbreunig.com/2025/06/22/how-contexts-fail-and-how-to-fix-them.html
- Anthropic,Equipping agents for the real world with Agent Skills,2025-10-16。https://www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills
- Agent Skills 规范(访问 2026-09-08)。https://agentskills.io/specification
- Anthropic,Demystifying evals for AI agents,2026-01-09。https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- promptfoo 自动化 prompt 测试(CI 闸口),2026-03-31。https://truetech.dev/ai-development/services/mlops/promptfoo-automated-prompt-testing.html
- Anthropic,Advanced tool use(Tool Search / defer_loading),2025-11-24。https://www.anthropic.com/engineering/advanced-tool-use
- Anthropic,Writing tools for agents,2025-09-11。https://www.anthropic.com/engineering/writing-tools-for-agents
- Anthropic,Code execution with MCP,2025-11-04。https://www.anthropic.com/engineering/code-execution-with-mcp
- Voyager(arXiv:2305.16291),2023-05-25。https://arxiv.org/abs/2305.16291
- Reflexion(arXiv:2303.11366),2023-03-20。https://arxiv.org/abs/2303.11366
- DeepMind,LLM 自我纠正边界(ICLR 2024,arXiv:2310.01798)。https://arxiv.org/abs/2310.01798
- MLflow Prompt Registry。https://mlflow.org/docs/3.6.0rc0/genai/prompt-registry/
- CrewAI 官方文档 Agents 概念页。https://docs.crewai.com/en/concepts/agents
- Agent 架构选型综述(二手转述,Cognition 立场软化出处),2026-09-04。https://www.thenewway.ai/agent-graphs-all-hype-or-the-new-way/
- 本地文献:D:/code/thinking/docs/config-registry.md、config-writing-standard.md、config-ledger.md、agent-config-sop.md、agent-arch-baseline.md、故障台账.md;D:/code/CrewAI docs/故障台账.md、logs/usage/、git 历史(e110280/a08305c/a5c9716);notes/AI工作/blog/2026-09-08-数字团队实战检验失败复盘.md。
数据口径说明
- token 口径:2026-08-31 起 usage 落盘为实例去重真实值;5× 虚增口径仅适用于 2026-08-31 修复前的 console 打印值。博客首战 17 个 run 落盘于修复之后,usage.json 已是真实值(per_task 求和与 total 精确相等,自洽验证通过):合计 10,442,852 token,prompt 10,067,356 / completion 375,496 ≈ 26.8:1,619 次请求;早期稿"209 万实耗"系误用 ÷5 口径,已更正。"M7 49.9 万"为 dev_fe 岗 prompt token(故障台账),"M10a 82.9 万"为该 run usage 落盘合计,两者粒度不同,图中已分别标注。
- 未核实项集中声明:①ZCode 侧"将近 5000 万 token 免费额度"为自报口径,无逐 run 台账背书;②"Anthropic 删 Claude Code 超 80% system prompt 编码评测无可测量损失"为二手转述,原帖未抓到(多家二手一致);③Claude Code 2026 年 3-4 月质量事故归因(推理强度下调 + 清理 bug + system prompt 变更叠加)为 postmortem 二手;④MAST 14 类分类法引自本地基线文档,其失败率区间数据本次未获一手出处;⑤Cognition 2026-04 立场软化为二手综述转述;⑥CrewAI role-goal-backstory 三件套官方无性能增益实证。
- 本地数据:行数、token、耗时均来自 docs/config-registry.md(2026-09-06 实测)、docs/config-ledger.md、docs/故障台账.md 与 D:/code/CrewAI logs/usage/ 落盘文件,逐条可回查。
AI 辅助调研生成,数据以原始文献为准,仅供学习研究参考。